Professional Machine Learning Engineerに合格するまで
本記事はこちらのサイトに掲載している内容と同一のものです。
徐々にはてなブログからこちらのサイトへ移行する予定ですので購読をお願いします。
はじめに
データサイエンス領域へのキャリアチェンジをすることになり、少しばかりデータサイエンス領域から離れていたこともあって機械学習関連のモダンツールについて体系的に理解したいということで Goolgle Cloud が主催する Google Cloud Certified Professional Machine Learning Engineer*1 (以下、MLE)の認定試験を受験してきました。 そこで、今回はこれから受験する方の参考になればとの思いで、試験の流れと対策法についてご紹介しようと思います。
Professional Machine Learning Engineerとは
Professional Machine Learning Engineer の認定試験について初めてお聞きになる方もおられるかと思うので、試験について簡単に説明しようと思います。
試験概要
Professional Machine Learning Engineer は、Google Cloud のテクノロジーにおける機械学習系サービスに関する実績あるモデルや手法を駆使して機械学習モデルの構築、評価、エンタープライズ化、最適化に関する知識を証明する資格試験となります。
Google Cloudのサービス以外にも一般的な機械学習の知識を問うてくることもあるため、機械学習の基本的な知識も有している必要があります。受験にあたっては特別な受験条件はありませんが、公式サイトでは「Google Cloud を使用したソリューションの設計と管理の1年以上を含む、3年以上の業界経験」が推奨されています。
また、機械学習関連の進歩が早く、Google Cloud の機械学習関連のサービスもアップデートが頻繁に行われるため、2023年11月に試験シラバスが改定されています。このため、出題範囲が大幅に変わっているので勉強する際は注意してください。データとモデルの管理(Vertex AI Experiments、Vertex AI Feature Storeなど)やMLソリューションのモニタリング(Vertex AI Molde Monitoring、Explainable AI)などは傾向が大きく異なっているので一度シラバスをご確認すると良いかと思います。
| 項目 | 内容 |
|---|---|
| 試験名 | Google Cloud Certified Professional Machine Learning Engineer |
| 試験環境 | テストセンター または リモート受験 |
| 言語 | 英語 |
| 試験時間 | 120分 |
| 問題数 | 50 ~ 60問 |
| 解答形式 | 1択 または 複数選択 |
| 受験料 | $200 |
試験の流れ
オンサイト試験を受験するまでの流れを簡単に記載します。受験は kryterion の Webassessor というサイトより申し込みを行い、指定した受験日時にテストセンターで受験をする流れとなっています。
既に Webassessor の日本語アカウントを持っている場合は、英語アカウントを新規に作成する必要があるため注意してください。また、その際にプロフィールで名前を入力する部分はローマ字表記ではなく、身分証と同じ表記でないと受験できないため名前は漢字で登録してください。
- Webassessor の英語アカウントを登録
- Webassessor から Machine Learning Engineer の試験申込
- 申込日時に試験会場で受付を済ませて会場PCで受験(身分証2つ提示)
- 解答を提出して試験結果を受領
- 数日以内にCredlyから登録メールアドレスに合格証(バッジ)が送付
対策教材
今回は主に Udemy での問題集を主の対策教材として利用しました。 これは以前にGCPのエントリー資格である「Associate Cloud Engineer」を受験した際に Udemy の問題集を解くことで効率的に知識獲得と試験対策を同時に行える実感を得ていたため、今回も同様に問題集を解きながら不足した知識を補う形での対策を行うこととしました。
加えて、試験は英語のみの受験となっているため、英語での出題解答に慣れておくことも必要となってきます。そのため、扱う問題集も実際の試験を想定して英語の問題集を選定しておくと良いでしょう。以下の問題集は試験範囲を網羅的にカバーできており、扱う問題数も300問もあるため私はこちらを購入して利用しました。
また、Machine Learning についての経験が浅い人は日本語の問題集から解き始めた方が理解しやすいと思いますので、以下の Cloud Studies JP さんと言う作成者の方の問題集から始められることをお勧めします。Cloud Studies JP さんも英語で MLE の問題集を出しているのですが、上記の Alex Levkovich さんの問題集で量と質の両方をカバーできるため、こちらを購入するだけで良いと思います。
勉強方法
最も気になる勉強方法についてこれ以降では記載します。
主に仕事をしながらの受験を試みたため、勉強は仕事後に行なっていました。合格するためには7割以上の正答率を獲得すれば良いと言われているため、全ての問題に正解するための完璧な知識は必要ないですが、出題範囲も広く、Google が推奨するベストプラクティスに関する知識も求められるので未経験の場合はそれなりに勉強時間が必要になると感じます。私もTensorflowを用いた場合に画像データをTFRecord 形式にコンバートしてレイテンシを最適化するなどのナレッジは初見でしたのでかなり勉強になりました。
勉強前の状態
私の場合は幸いにも仕事上で機械学習を扱っていたため、基本的な機械学習に関する基礎知識はある状態からの学習でした。例えば、PrecisionやRecallなど一般的な評価指標の意味や扱い方、勾配ブースティングモデルやニューラルネットワークのアルゴリズムなどは理解している状態でした。
ただし、実際の機械学習を仕事で扱う現場からは2年ほど離れていたため、TFXなど最新のエコシステム周りのアップデートなどは追従できていない状態だったので、勉強を始めてみて割としっかりと対策をしないと受からないなという印象を持ちました。
勉強方法・期間
はじめに合格するまでのざっくりとしたロードマップを作成しました。私が設定した合格ロードマップは以下です。勉強開始から合格までに要した期間はざっくりと4週間程度でした。1日あたり約2時間だったことを考えると総勉強時間は30時間くらいだったかと思います。
- 1週間: 問題集を解きながら試験項目範囲について理解
- 2週目: 問題集を解きながら間違えた部分を公式ドキュメント参照して理解
- 3週目: 50問連続して試験問題を解くことで試験を想定してた対策を実施
- 4周目: 時間の許す限り総復習
また、ロードマップを見て既に察した方もおられるかと思いますが、勉強方法は基本的に 問題集を解いて復習する勉強法 で行っていました。はじめは知識不足と英語への不慣れさもあり、勉強が捗らない時間もあります。が、大体2週目くらいを過ぎたあたりから知識も定着して、頻出の英語表現や単語にも慣れてくるため問題もすらすら解けるようになります。ここまで来ればあとは問題集をひたすら繰り返して苦手を克服していけば、なんとかなるだろうと妙に自信がつきます。
別の方の対策方法には Google Cloud Skills Boost(ハンズオン) や Coursera(オンライン講座) を活用したなども記事もございますが、個人的には問題集を解く方が効率的で、どうしても理解できない部分はGCPコンソール画面で実際に操作する方がコスパが良いと感じます。このあたりについては人によって感じ方が異なる部分かと思いますので参考までに。
Udemy の問題集では1問1答形式ではなく、実際の試験と同じ50問を解答した後に正答判別をする仕様のため、勉強始めの頃は連続して50問を解き切るのがしんどい部分があります。そのため、私は勉強を始めたばかりの頃は10問だけ解答し、正誤を見て復習するという流れを繰り返して集中を保ちながら勉強を行なっておりました。知識獲得と不慣れな英語で勉強が捗らない、継続が困難などの悩みがある方は是非参考にしてもらえればと思います。
試験と所感
実際の試験を受けてみた後の所感ですが、新シラバスへどれくらい対応して知識を深められるかが合格への鍵だと思いました。
旧シラバスでは AI Platform*2 に関する知見を問う問題が多かったですが、新シラバスではサービスのアップデートにより Vertex AI に関する知見を問う問題が主となっています。そのため、旧シラバスを中心とした勉強はあまり意味がなく、新シラバスを意識して Vertex AI Occupancy Analytics*3 や Vertex Explainable AI*4 などの新しいサービスなどを中心に理解されていくことをおすすめします。
結果として私自身も無事に合格することができました。私自身はすごい高度な知識を持っているわけでも、英語が得意なわけでもありません。ですが、しっかり対策を講じることでちゃんと合格できるので、皆様も受験を決めたらしっかり対策をしていきいましょう。
まとめ
最後に「Professional Machine Learning Engineer」の資格取得に向けた参考記事を投稿しましたがいかがでしたでしょうか。これから受験する人の参考になれば幸いです。
terraformで if 分を扱ってみたい
はじめに
terraformでモジュールを定義している際にIF文を扱いたいと思った際に調べたことをまとめておきます。
結論から言うとTerraformでは他のプログラミング言語で実装されているIF文と呼ばれる構文は定義されていません。
ただ、どうしてもIF文を使いたいというシーンは実際にはあったりするので、今回はTerraformでIF文ライクな記述をする方法を記載します。
また、追加で補足しておくとTerraformでのIF文による宣言的記述は推奨はされていないため、可能であれば回避するのがベターであるのでその点は理解した上で活用してもらえると良いかと思います。
Terraformとは
まずはTerraformについて簡単に触れておきます。
Terraformとはインフラを宣言的にコードで記述、定義された構造化データに基づいてインフラ構築を自動化できるツールです。一般的にIaCと呼ばれるもの該当します。Terraformを利用するメリットとしては、誰でも同一のインフラ構成を再現できることと、工数削減効果の2つが挙げられます。 この宣言されたコードをGitで共有することで誰しもが同じ環境を構築することができ、インフラ構成もアプリケーションのソースのバージョンと対応して管理していくことができます。
加えて、TerraformではProviderと言われるプラグインベースの機能拡張を行うことができるサポート機能が用意されています。この Provider を使うことで様々な外部のインフラリソースを制御することを実現しています。
利用可能な Provider は TerraformRegsitory で確認が可能です。
TerraformRegistoryに登録されているProviderには4つのランク分けがされており、hashicorp社所有やhashicorp社がメンテナンスしている Official の物から、ユーザやコミュニティによって登録されたものなどがあります。メジャーどころのGCPやAWSは Official に該当しているため、バージョンアップ等のメンテナンスが継続して行われていることも安心して使用することができる一因となっています。
実装方法
Terraformでは冒頭で述べたようにIF文が存在しません。
そこで、IF文を実現するためにリソースブロックの個数を定義することが可能な count のメタパラメータと三項演算子を組み合わせて、IF文のような振る舞いを定義していきます。
今回は参考例として GCP 上での ComputeEngine のリソース定義を題材として、実際の記述方法を記していこうと思います。
まず初めにディレクトリ構成です。
terraform ディレクトリをルートディレクトリとして環境別のディレクトリとモジュールのディレクトリを配置しております。モジュールディレクトリでは GCP で扱うComputeEngine のテンプレートを用意し、環境別のディレクトリに配置した dev ディレクトリ以下からこれらのテンプレートを呼び出してリソース定義をするようにします。
terraform/
  ├ environments
  │   └ dev
  │     ├ backend.tf
  │     └ main.tf
  └ modules/
      └ vm
        ├ main.tf
        ├ variables.tf
        └ output.tf
terraform/environments/dev/backend.tf ファイルには state ファイルを管理・共有するための backend 機能を利用するためのリモートストレージの場所を記述します。今回は GCP ということで GSC を対象としています。
terraform {
  backend "gcs" {
    bucket = "gsbucket-terraform"
    prefix = "terraform/dev"
  }
}
続いて、terraform/modules/main.tf ファイルです。
モジュールでは実際のインフラにて利用するリソースに関する情報を定義します。ポイントは ComputeEngine を定義するリソースブロックの中で count パラメータと三項演算子を組み合わせて、変数の値に応じてリソース数を 0 か 1 に振り分けている点になります。 この場合、vm_instance_type にcpuを指定した場合は上段のリソースブロックが採用され、gpuを指定した場合は下段のGPUカードを付与されたリソースブロックを採用することになります。
resource "google_compute_instance" "vm_instance" {
  count        = var.vm_instance_type == "cpu" ? 1 : 0
  name         = var.vm_instance_name
  machine_type = var.vm_instance_machine_type
  zone         = "asia-northeast1"

  boot_disk {
    initialize_params {
      image = var.vm_instance_image
    }
  }
  network_interface {
    network = "default"
    access_config {
    }
  }
}


resource "google_compute_instance" "vm_instance" {
  count        = var.vm_instance_type == "gpu" ? 1 : 0
  name         = var.vm_instance_name
  machine_type = var.vm_instance_machine_type
  zone         = "asia-northeast1"

  boot_disk {
    initialize_params {
      image = var.vm_instance_image
    }
  }
  network_interface {
    network = "default"
    access_config {
    }
  }
  guest_accelerator {
    type = "nvidia-tesla-k80"
    count = 1
  }
}
最後にterraform/environments/dev/main.tf ファイルです。
モジュールで定義したテンプレートを呼び出して、変数としていた要素に適切なパラメータを与えてリソース定義を完成させます。
今回は vm_instance_type に cpu を指定していることから、モジュールで定義したCPUのみのVMインスタンスを立ち上げる
このようにして Terraform にてIF文を再現することを行います。
# terraformの設定
terraform {
  required_providers {
    google = {
      source  = "hashicorp/google"
      version = "4.4.0"
    }
  }
}

# terraformで利用するプロバイダーの設定
provider "google" {
  project = " <GCPのプロジェクト名> "
  region  = "asia-northeast1"
}

# モジュールを利用した構成定義
module "vm-dev" {
  source                   = "../../modules/vm"
  vm_instance_type         = "cpu"
  vm_instance_name         = "vm-instance-dev"
  vm_instance_machine_type = "custom-4-10240"
  vm_instance_image        = "ubuntu-os-cloud/ubuntu-2204-lts"
}
まとめ
いかがでしたでしょうか。今回はあくまで自分の備忘録として Terraform でIF文を再現する方法をまとめてみました。
TerraformでIF文を定義することは推奨されていませんが、どうしてもIF文を使う必要がある方の参考になれば幸いです。


GCP Associate Cloud Engineer を受けたよ
はじめに
最近仕事でGCPを触る機会が増えてきたので、 Google Cloud 認定資格である「Associate Cloud Engineer」の資格を取得しました。この記事では学習前の状態から実際の勉強方法についてこれから取得を目指す方の参考になればという思いで参考情報を記述していこうと思います。
勉強開始前の試験概要の調査段階では、最上位の資格を受けようと思ったのですが、不合格だった場合の再受験ポリシー*1があるため、まずはエントリーということで「Associate Cloud Engineer」試験を受験してみました。
次からはまず初めに試験の簡単な概要説明をした後に、試験までの学習方法について記載していこうと思います。実際の試験対策方法について知りたいという方はこちらから読んでもらえればと思います。
Associate Cloud Engineer試験
Associate Cloud Engineer試験はGoogle Cloud 認定資格の中でエントリーに位置する資格となります。
エントリーの資格のため特定の分野にフォーカスした試験ではなく、GCPにおける全般の基礎的な幅広い知識が要求される内容となっております。そのため、得意不得意を作るのではなく、GCPの基本的なサービスを満遍なく理解しておく必要があります。とは言っても、GCPには100以上ものサービスがあるのですが、全てを理解する必要はなく、以下のサービスを押さえておけば問題なく得点できると思います。
- Compute Engine
- VPC
- IAM
- Cloud Billing
- Cloud Storage
- App Engine
- Cloud Run
- Google Kubenetes Engine
- Cloud Functions
- Cloud SQL
- Cloud Spanner
- Cloud Bigtable
- Cloud Firestore
- Memorystore
- BigQuery
- Operation Suite
また、単純にサービス概要だけを理解すれば良いわけではなく、SDK等のコマンドなどの知識も試験では要求されるので、GCPの実利用経験もある程度要求される点に注意が必要です。 このあたりはエンジニアの方であれば特に問題にはならないのですが、エンジニア以外の方からすると少し理解しづらい部分になるかと思いますので、この点を考慮した勉強時間の確保をすることを意識してもらえると良いかと思います。
勉強開始前の状態
試験対策の内容を記載する前に学習前の状態について記載しておきます。
GCPを本格的に触り始めて半年程度で、サービスはGKEを主軸としており、その他のサービスは必要があれば扱うという感じでした。とは言え、GKEだけでは完結しないのでVPCやGCSといった基本的なサービスは人並み程度には扱っている状態でした。ただ、IAMなどの権限やBillingについてはロール権限の問題であまり踏み込めておらずほとんど知識はありませんでした。
試験対策
では、本題の試験対策についてです。
勉強開始から合格までに要した期間は2週間でした。
基本的には 問題集を解いて復習する勉強法をベース として、参考程度に書籍を読むという流れで学習しました。あまりダラダラと対応したくはなかったので先に受験申込をして、受験日を決めてしまってから勉強をしました。この2週間は全て勉強に時間を費やしたわけではなく、1日あたり平均して2〜3時間程度の学習時間だったと思います。仕事が終わってから寝る前までの2時間程度勉強するといった感じですね。
試験対策に用いたものですが、Udemyの「Google Cloud Associate Cloud Engineer模擬試験問題集
」と書籍の「図解即戦力 Google Cloudのしくみと技術がこれ1冊でしっかりわかる教科書」を購入して利用しました。
まず模擬問題集についてですが、こちらの内容は本番にかなり近い形式で問題が出題されるので実際の本番を想定した勉強を行うことができます。ただ、注意する点は全く同じ問題は出題されないため、問題を丸覚えする学習法は避けてください。正解することよりもしっかりと問題で問われている内容や状態が理解・説明できるようになるために正解不正解を問わず解説文を熟読するようなイメージで学習してもらえると良いです。 こちらの問題集を3周程度して正答率が9割を超えるようになれば、合格ラインは越えられる最低限の知識は備えられているかと思います。
続いて、書籍での学習です。
問題集と並行して隙間時間で書籍を使って知識を補っていきました。こちらの書籍を選定した理由はスラスラと読めてしまうことと、図解が多いので視覚的に知識を記憶できる点で選定しました。
書籍の位置付けとしては先ほどお伝えした模擬問題集では分野や知識にムラができてしまう為、その点を補うための材料として活用しました。特に問題集ではNoSQL周りの問題があまり多くは取り扱われていないため、Cloud Bigtable や FireStoreのモードなどと言った曖昧な部分の知識を補足しておくとより合格を手繰り寄せられるのかと思います。

ここまで対策をしておけば、試験は若干選択肢に迷う問題も数問出てくるかと思いますが、それほど難しくはないなと感じるほどになっているかと思います。
ただ、それでもやはり心配、確実に合格したいという方はさらに以下の書籍を参考に知識を補っていくのと良いかと思います。(私は2週間という期限付きでしたので以下の2つはやりませんでした。)
こちらの図書は、私が試験対策を開始する前にした下調べで、他の合格体験記を投稿してくださっている方の多くが「合格するならコレ」と推薦している書籍でしたので、こちらまでやっておけばほぼ合格は間違いないかと思います。

試験結果
試験結果ですが、初めに記載したように無事に合格していました。
試験内容については Googleの試験利用規約 にて禁止されておりますので記載はしませんが、問題文をよく読んで持っている知識をフル活用していけば問題なく解ける内容だと思います。実際にGCPを触っている実務経験がある人の方がより試験難易度が低くなる傾向はあるとは思いますが、とは言え、ここで記載した試験対策を実施することで実務経験がなくても合格は可能かと思います。
余談にはなりますが、テストセンターで試験を受けたのですが、その場で合否判定が出るのは良いですよね。
まとめ
最後に「Associate Cloud Engineer」の資格取得に向けた参考記事を投稿しましたがいかがでしたでしょうか。これから受験する人の参考になれば幸いです。
ネットワークスペシャリストに合格するまでの勉強法
本記事で記載すること
本記事ではネットワークスペシャリストに合格するまでの実体験をもとに学習として取り組んだ内容を中心に簡単に記載しようと思います.
それに伴って本記載で掲載する内容は以下としたいと思います.
- 学習方法とスケジュール
- 直前対策
- 全体所感
ネットワークスペシャリスト試験とは何かと言った概要情報については本記事では扱わないので、試験について知りたいという方は以下の公式サイトをご覧ください.また、こちらのサイトにも試験についての解説記事が載っているので参考にしてみてください.
また、学習スタート時の状況や学習前の知識量についても触れておくと以下のような感じでした.ネットワークに関する基本的な知識は抑えている程度でしたね.
勉強方法
では、早速試験日までの勉強方法について書いていこうと思います.
大きく分けて試験対策としては午前対策と午後対策という大きな括りに分けて勉強をしました.
午前対策
午前対策では主に以下の「ネットワークスペシャリストドットコム」のサイトを利用して学習を行いました.
私の場合は午前Ⅰ試験は免除で、午前Ⅱのみを対象としていたためこのサイトでの学習しかしませんでした.具体的にはこちらのサイトの過去問道場(1問1答)を用いて1日10問以上解くと言った取り組みを継続して行いました.こちらのサイトでは解説が非常に丁寧に記載してあるので、間違えた場合でも解説を見て正しい知識の習得が図れるため有力なツールです.ある程度の前提知識をお持ちの方であれば午前対策は参考書などにお金をかけずにこういったサイトのみで十分かと思います.
また、無線通信の規格であるIEEE802.11acなどといった周波数帯と通信速度の対応関係の暗記は必須項目となっているかと思いますが、直前に詰め込むよりも当該ツールを用いてコツコツと繰り返し学習しながら身につけていく方が試験中も焦ることなく解くことができるので個人的にはおすすめです.
午後対策
午後対策は知識の応用方法と記述問題に対する解法理解を中心に参考問題集による学習を行いました.学習に利用した書籍は「2022 ネットワークスペシャリスト 専門知識+午後問題 の重点対策」を利用しました.

こちらの書籍は良問を取り扱っているだけでなく、問題1つ1つに丁寧な解説が記載してある点が本書を選定した理由になっています.特に、1冊で10章という長編の構成となっており、出題範囲の全てを解説と共に満遍なく学習することができます.この1冊を複数回繰り返し解くことで知識の抜け漏れから知識の応用、記述解答に対するポイントまでを網羅的にカバーすることができます.
そのため、様々な参考書に手を出すよりも本書を何回も解く方が効果的だと言えます.
ただ、上記の書籍は基本的な知識は備えた前提で扱う応用的な書籍であるため、少し知識に不安がある方は以下の書籍と組み合わせて基本を徹底して習得しながら学習すると良いと思います.

午後対策の学習方法は主に重点対策の書籍を用いて、1日1設問以上を解くことを目標に勉強をしました.全ての章の問題を3週くらい実施したら、大体の問題傾向と記述方法は自然と身につくのでこの勉強法だけで試験対策として事足りるかと思います.
ちなみに余談になりますが、午後対策として広い出題範囲から得意分野に山を張って学習すると言った内容を散見することがありますが、個人的にはあまりお勧めしません.理由は2つあって、1つは得意分野が必ずしも出題されるとは限らないため、山が外れた際に問題が解けないリスクがあること.そして、もう1つは知識を備えて業務等でネットワークの知識を活かせる人材にはならないためです.あくまで試験は手段であり、ネットワークスペシャリスト試験を通じて技術者として正しいスキルや知識を身につけることが目的だと私は考えております.そのため、山を張って学習するのではなく、時間をかけてでも良いのでしっかり網羅的に学習することが大事だと思います.その方が合格の確率も上がりますしね.
全体のスケジュール
前章までで試験対策の具体的な内容について記載したのでスケジュールについて言及しておきます.
午前対策は年明けから開始して試験日まで毎日継続しました.午後対策は2月中旬より開始して時間が取れる範囲で、1日最低でも1時間程度の学習時間を確保して試験対策を実施することに努めました.午後対策については知識に不安がある方はもう少し学習期間を長めにとったほうが良いと思うので、午前対策と同じ時期に始めてしまっても良いかと思います.
| 1月 | 2月 | 3月 | 4月 | 4/17 | |
|---|---|---|---|---|---|
| 午前対策 | 1/10 → | → | → | → | → |
| 午後対策 | 2/15 → | → | → | → |
全体所管
試験傾向
令和4年度春季のネットワークスペシャリスト試験の傾向ですが、個人的には午後Ⅱ試験はそこまで難易度が高くはない問題であったため、いかに午後Ⅰ試験を突破するかが合格の鍵だったように感じました.
今回の午後Ⅰ試験も例年通りで単純な知識を問われるというよりは複合的な知識を問われる傾向が強かったため、ネットワークのみならず複数の分野・領域に跨って広く正確な知識を習得・活用していることが求められていたかと思います.例えば、設問2はVPN接続を題材にしたネットワーク設計の問題、設問3などはケルベロス認証を題材にしたネットワークセキュリティの問題などといったネットワーク以外の仕組みについても知識が問われていました.
記述式の解答であるため、単に知っているというだけではNGで、知識を駆使して状況を理解しながら、解答を導き出すことが必要になってきます.この点からも応用力を身につけることを意識して午後対策をしっかり実施することが重要だったかと思います.
そして、やはり試験を通じて感じたこととして、合格に近づくためにはいかに午後問題を乗り越えるかが鍵となってくるとため、午後対策にどれだけ時間を割けたかが重要になってくると痛感しました.これから試験を受ける方は午後の対策時間を意識して勉強されると良いと思います.
試験結果
令和4年度春季のネットワークスペシャリスト試験の結果ですが無事に合格していました.いざ合格発表の直前となると緊張するものですね.
1年に1度しか受験できないため、合格を逃すと次の合格タイミングが1年後になってしまうので、短期集中して学習を行い、一発合格を狙っていくのが良いと思います.

まとめ
今回は情報処理技術者試験のネットワークスペシャリスト試験における学習方法について記載しました.技術系の資格を取っても業務に活かせないという考えをお持ちの方はいるかと思いますが、資格は対外的に自身の能力を証明する手段としては有効ですし、直接的に業務に役立たなくとも間接的に業務理解を促進したりしてくれるはずです.是非皆さんも積極的に資格取得を目指して取り組んでいってもらえると良いかと思います.
次は秋季のデータベーススペシャリスト合格を目指して気持ちを新たに勉強をしていこうと思います.

S3で5GB以上のファイルを操作する方法
はじめに
データ分析に関わる人であれば誰でも一度は AWS の S3 をストレージとして利用したことはあるかと思います.
今回は Jupyter Notebook より boto3 を介して S3 に5GB以上のデータを保存しようとした際に詰まった内容について,同様の問題で苦しむ人の一助になればという想いと自身の備忘録も兼ねてまとめていきたいと思います.
実行環境
まず初めに実行環境について記載しておきます.
$ sw_vers
ProductName:    Mac OS X
ProductVersion: 10.15.7
BuildVersion:   19H1519

$ python -V
Python 3.9.1
発生事象
では,本題の詰まった事象についてです.
Jupyter Notebook から boto3 を介して S3 に 5 GB 以上のデータを保存しようとしたところ,「ClientError」によってアップロードが正常に行えないという事象に直面しました.具体的なコードは以下です.
import io
import os
import boto3
import random
import numpy as np
import pandas as pd

# faker
import faker
from faker import Faker

# boto3
from boto3 import Session
from botocore.session import get_session
from botocore.session import ClientError, ParamValidationError

class GenerateDummyData:
    """ダミーデータ生成クラス"""

    def __init__(self, seed:int=None):
        """
        Args:
             seed: ランダム生成かかわるシード値
        Returns:
        """
        self.fake = Faker()
        if seed: Faker.seed(seed)

    def create_rows(self, rows:int=1):
        """
        Args:
            rows: 生成するレコード数
        Returns:
            df: ダミーのデータフレーム
        """
        output = [{
            "name": self.fake.name(),
            "address": self.fake.address(),
            "email": self.fake.email(),
            "bs": self.fake.bs(),
            "city": self.fake.city(),
            "state": self.fake.state(),
            "date_time": self.fake.date_time(),
            "randomdata": random.randint(1000, 2000) } for x in range(rows)]

        df = pd.DataFrame(output)
        return df


def put_s3(dataframe: pd.DataFrame, bucket:str, key:str) -> bool:
    """データフレームをS3に保存する関数
    Args:
        dataframe: 保存するデータフレーム
        bucket: s3の保存するバケット名
        key: s3の保存するキー名
    Returns:
        bool: 保存実施の成否
    """
    try:
        session = get_session()
        autorefresh_session = Session(botocore_session=session)
        s3_client = autorefresh_session.client('s3')

        csv_buffer = io.StringIO()
        dataframe.to_csv(csv_buffer, index=False, header=True, encoding='utf-8')
        s3_client.put_object(
            Bucket=bucket,
            Key=key,
            Body=csv_buffer.getvalue()
        )
        return True
    except ClientEror as e:
        return False

# ダミーデータ生成
#  5GB以上になるように大量のレコードを生成
df = generator.create_rows(10000000000)

# ストレージへの保存
put_s3(df, "sample-bucket", "storage/dataframe/df.csv")
上記のコードより発生したエラー内容は以下です.
エラー内容をみるとファイルサイズが最大値を超えているためにエラーが起きていることが分かります.
ClientError: An error occurred (EntityTooLarge) when calling the PutObject operation: Your proposed upload exceeds the maximum allowed size
原因と解決策
ClientErrorが発生した理由ですが,boto3のAPIで用意しているput_object メソッドでアップロードできるオブジェクトサイズは5GBという制限があるようです.
boto3の公式ドキュメントには明確な記載はありませんでしたが,AWS公式ドキュメントには以下のようにしっかりS3の仕様について言及がありました.
- 1 回の PUT オペレーションでは、最大 5GB の単一のオブジェクトをアップロード可能
- マルチパートアップロード API を使用すると、最大 5 TB のサイズの単一の大容量オブジェクトをアップロードできます
そのため,S3の仕様に則ってboto3側のAPIでも同様にPUTオペレーションでの制限がかかるのは当然のことだと思います.では,どのようにこの問題に対処するのかという部分ですが,大きく2つがあります. 1つはboto3のTransferAPIを利用する方法と,もう1つはpandasのto_csvメソッドを利用する方法です.
それぞれの実装方法を以下に示しながら解説していきます.
- boto3の S3 Transfers の利用
boto3の S3 Transfers を利用した実装方法は以下になります.
この S3 Transfer のモジュールの特徴は指定したファイルサイズを上回った際に、自動的にマルチパート転送に切り替わるという機能を持っています.これによってファイルサイズが5GB以上になった場合でも,マルチパートアップロードを利用して最大 5TB までのデータをアップロードすることが可能になります.
from tempfile import NamedTemporaryFile

from boto3 import Session
from botocore.session import get_session
from botocore.session import ClientError, ParamValidationError
from boto3.s3.transfer import S3Transfer
from boto3.s3.transfer import TransferConfig

def put_s3(dataframe: pd.DataFrame, bucket:str, key:str) -> bool:
    """データフレームをS3に保存する関数
    Args:
        dataframe: 保存するデータフレーム
        bucket: s3の保存するバケット名
        key: s3の保存するキー名
    Returns:
        bool: 保存実施の成否
    """
    try:
        session = get_session()
        autorefresh_session = Session(botocore_session=session)
        s3_client = autorefresh_session.client('s3')

        f = NamedTemporaryFile()
        dataframe.to_csv(f, index=False, header=True, encoding='utf-8')

        config = TransferConfig(
            multipart_threshold = 8 * 1024 * 1024,
            max_concurrency = 10,
            multipart_chunksize = 8388608,
            num_download_attempts = 10,
            max_io_queue = 100
        )
        transfer = S3Transfer(client=s3_client, config=config)
        transfer.upload_file(
            filename=f.name,
            bucket=bucket,
            key=key
        )
        return True
    except ClientEror as e:
        return False
実装もそこまで難しく S3Transfer クラスと TransferConfig クラスをインポートして利用するだけです.
閾値等の各種パラメータの設定を TransferConfig クラスにて行い,設定したオブジェクトを S3Transfer に渡してインスタンス化するだけでマルチパートアップロードに対応した処理が記載できます.注意点があるとすれば,この S3Transfer クラスのメソッドには download_fileと upload_file のメソッドしか定義されていないため,バイナリやバッファを直接指定することができない点になります.そのため,上記の実装ではアップロードする対象のオブジェクトを一時ファイルとして出力して一時ファイルのパスを指定するとった処理で記載しています.
- pandasの to_csv メソッド利用
続いてシンプルにpandasの to_csv のみで利用する方法です.
注意点としてPandasのバージョンが 0.20.1 以上でかつ,別途 s3fs のライブラリのインストールが必要になります.
s3fs はユーザ領域にS3をマウントしてファイルを保存するためAPIによる制約を受けなくなるということです.普段Pandasに慣れている人はこちらの方が可読性が高くて,学習コストもほとんどゼロに等しいため、バージョン制約や s3fs のインストール制約がない方はこちらの方法を利用する方が無難かと思われます.
def put_s3(dataframe: pd.DataFrame, bucket:str, key:str) -> bool:
    """データフレームをS3に保存する関数
    Args:
        dataframe: 保存するデータフレーム
        bucket: s3の保存するバケット名
        key: s3の保存するキー名
    Returns:
        bool: 保存実施の成否
    """
    try:
        dataframe.to_csv(f"s3://{bucket}/{key}", header=True, index=False)
        return True
    except:
        return False
リリースノートに Pandas の機能アップデート情報が記載されていますので興味があればそちらも是非参照してみてください.
まとめ
今回は備忘録も兼ねてクラウドサービスの活用という文脈でS3への大容量ファイルのアップロード方法についての記事を記載しました.
普段からライブラリの操作についてはドキュメントを割と目を通してから利用する方ですが,改めて公式ドキュメントをしっかり読むことの重要性を再認識しました.S3は開発でも機械学習でも利用頻度が高いクラウドサービスだと思うので参考になればと思います.

参考情報
SHAPの各種可視化プロットを日本語化する
今回の記事は備忘録も兼ねて軽めの内容を記載していきます.
はじめに
機械学習のモデル解釈で頻繁に用いられるのがSHAPです.
実際のデータ分析の現場で頻繁に用いられるライブラリとしては shap があります.
個別のサンプルにおけるSHAP Valueの傾向を確認する force_plot や大局的なSHAP Valueを確認する summary_plot 、変数とSHAP Valueの関係を確認する dependence_plot など,モデル傾向を確認するための便利な可視化メソッドが用意されておりこれらを適切に用いることで可視化をモデル
の解釈を行うことができます.
今回のテーマではライブラリの基本的な操作方法については言及しないので,基本的な操作方法について把握したいという方は以下のサイトなどを参照してみてください.
実行環境
今回の実行環境は以下となります.
$ sw_vers
ProductName:    Mac OS X
ProductVersion: 10.14.6
BuildVersion:   18G6042

$ python -V
Python 3.9.1
問題
さて,通常アナリストが分析を実施してモデルを解釈する際には特段気にする必要はないのですが、機械学習のモデル解釈性をアナリスト以外の人にレポーティングする際には注意する必要があります.
それは shap ライブラリを用いた可視化を行った際に特徴量として利用したカラム名の英字表記になります.何が問題なのかをもう少し言及すると、アナリストは実際にデータを扱っているため英字のカラム名が何を意味するデータ項目なのかを把握していますが、初見で見た人はそのデータ項目が何を指しているのかを理解することは容易ではありません.つまり、報告される側に立って可視化するためにカラム名をマルチバイト文字(日本語)に変更する修正をする対応が必要になってきます.
そこで,直面する問題がマルチバイト文字の文字化けです.
実際の例を見てみましょう.
データはUCIの公開データセットである Adult Data Set を利用します.
当該データセットではデフォルトでは英字になっていますが、今回はこれらのカラムを日本語に変更して扱います. カラムのそれぞれにおける英字と日本語の対応は以下の通りです.
|カラム| 日本語 |
|:---:|:---:|
| Age | 年齢 |
| Workclass | 労働階級 |
| Education-Num | 教育年数 |
| Marital Status | 婚姻状態 |
| Occupation | 職業 |
| Relationship | 続柄 |
| Race | 人種 |
| Sex | 性別 |
| Capital Gain | 資産売却益 |
| Capital Loss | 資産売却損 |
| Hours per week | 労働時間 |
| Country | 出身国 |
では、早速実際のSHAPを出力するコードと出力結果を見ていきましょう.
import os
import sys
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import lightgbm as lgb
import xgboost as xgb
import shap
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, auc, roc_curve
shap.initjs()

seed = 42

# データ読み込み
X,y = shap.datasets.adult()
X_display,y_display = shap.datasets.adult(display=True)

# カラム名変更
X.columns = [
    "年齢", "労働階級", "教育年数", "婚姻状態", "職業", "続柄",
    "人種", "性別", "資産売却益", "資産売却損", "労働時間", "出身国",
]

# 学習データセット作成
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=seed)
lgb_train = lgb.Dataset(X_train, label=y_train)
lgb_test = lgb.Dataset(X_test, label=y_test)

# パラメータ
params = {
    "objective": "binary",
    "metric": "acu",
}

# モデルの学習
lgb_m = lgb.train(
    params,
    lgb_train,
    10000,
    valid_sets=lgb_test,
    early_stopping_rounds=50,
    verbose_eval=1000,
)

# shap可視化
explainer = shap.TreeExplainer(model=lgb_model)
shap_values = explainer.shap_values(X=X_test)
shap.summary_plot(shap_values[1],X_test)
モデルはLightGBMを用いて作成したその後に各特徴量のShap値をViolinPlotで出力しています. 結果は以下のようなグラフになりました.ご覧の通り文字化けしていて、どの特徴量がモデルの予測結果に寄与しているのかが分かりません. つまり、このようにshapを用いて日本語の可視化を行った場合は結果が読み取れないグラフが出来上がったしまいます.
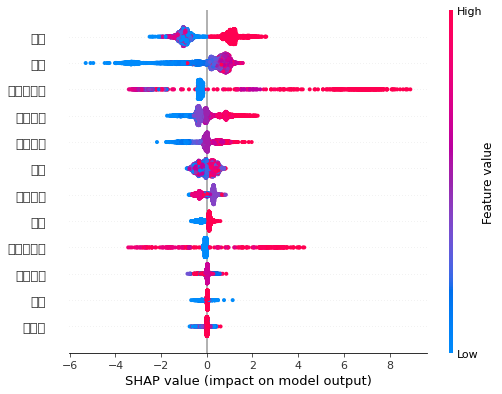
対策
前章で記載した問題についての対策を述べていきます. この文字化けが発生する原因はmaplotlibで日本語フォントが扱えないことが要因になります. そのため、matplotlibで日本語フォントが扱えるように対応するだけで解決できます.そこで、japanize-matplotlibをインストールして利用します.
$ pip install japanize-matplotlib
さて、実装方法ですが非常にシンプルで import japanize_matplotlib をimportするだけです.
import os
import sys
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib # ここを追加するだけ
import lightgbm as lgb
import xgboost as xgb
import shap
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, auc, roc_curve
shap.initjs()

seed = 42

# データ読み込み
X,y = shap.datasets.adult()
X_display,y_display = shap.datasets.adult(display=True)

# カラム名変更
X.columns = [
    "年齢", "労働階級", "教育年数", "婚姻状態", "職業", "続柄",
    "人種", "性別", "資産売却益", "資産売却損", "労働時間", "出身国",
]

# 学習データセット作成
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=seed)
lgb_train = lgb.Dataset(X_train, label=y_train)
lgb_test = lgb.Dataset(X_test, label=y_test)

# パラメータ
params = {
    "objective": "binary",
    "metric": "auc",
}

# モデルの学習
lgb_m = lgb.train(
    params,
    lgb_train,
    10000,
    valid_sets=lgb_test,
    early_stopping_rounds=50,
    verbose_eval=1000,
)

# shap可視化
explainer = shap.TreeExplainer(model=lgb_model)
shap_values = explainer.shap_values(X=X_test)
shap.summary_plot(shap_values[1],X_test)
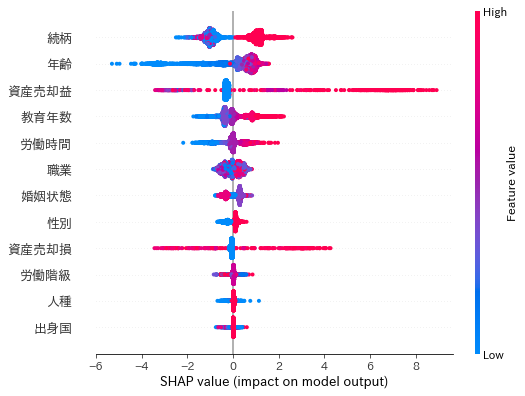
出力結果ですが、先程のソースコードを改修することなく文字化けが解消されました. 可視化周りは意外とこういった細かい部分で詰まることが多いのですが、いったん解決策を知ると案外大したことない問題だったといったことが多い気がします.とは言え、知らないと多くの時間を浪費してしまうこともあるので些細なTipsを把握しておくのも大事ですよね.
まとめ
最近忙しくて更新が滞っていたのですが、また意識して更新するようにしていきたいと思います. 内容についてもあまり世間一般的に記事がまとめられていない内容について積極的に記載していきたいと思います.

flowWeaverでSankey Diagramの可視化
今回は可視化の記事についてです.
Sankey Diagramとは
SanKey Diagramとは各プロセス間の流量を表現する可視化パターンです.矢印の向きでプロセスの向きを表して,その矢印の太さで流れの量を表しています.活用シーンとしては,ユーザ導線などを視覚的にみたい時などに利用されます.よく見かける例としてはGoogle Analyticsのユーザーフローで示されるようなサイト内でのユーザーの動きを可視化する際などに使われたりしています。
ちなみに以下の「データビジュアライゼーションのデザインパターン20」
の書籍内でもSankey Diagramの解説が載っているので,体系的に可視化について学ばれたい方は以下の書籍を読んでみることをお勧めします.

floWeaver
早速ですが今回はこのSankey DiagramをPythonを用いて可視化していきます.
私たちがPythonでSankey Diagramを可視化する際に利用するライブラリの選択肢としては,主にmatplotlibやPlotly,floWeaver があります.それぞれについて簡単に説明しておきます.
まず,matplotlibはデータ分析を扱っている人であれば誰でも一度は触ったことがある言わずと知れた可視化ライブラリです.こちらのライブラリでも実はSankey Diagramを扱うことができます.しかし、個人的には可視化された図が可読性が決して良いものではないためあまり好みではありません.そのため今回は本記事では扱わないこととします.
続いて,Plotlyです.Plotly は多様な可視化パターンに対応しながらインタラクティブな図を作成することができるツールです.Plotly を普段から慣れている方はこちらの Plotly を用いたSankey Diagramを利用することで可読性の高い図を学習コストも少なく生成できるため非常に良いかと思います.
そして、最後に floWeaver ですが、こちらはSankey Diagramの可視化に特化した可視化ライブラリになります.これまでの2つと比べると機能面で1つの可視化しかできないのかと思うかもしれませんが,Sankey Diagramの可視化に特化しているため,細かなチューニングが行えるのと,なんといっても可視化された図の可読性の高さが非常に高い点で扱う価値があると思います.
3つのライブラリをご紹介しましたが,こちらの記事ではあまり見慣れないという点で floWeaver を用いてSankey Diagramの実装を以降では扱っていきます.
実行環境
実行環境は以下となります.
$ sw_vers
ProductName:    Mac OS X
ProductVersion: 10.14.6
BuildVersion:   18G9028

$ python -V
Python 3.9.1
インストール
floWeaver のインストールはpipにて簡単に行えます.
$ pip install floweaver
加えてJupyterで floWeaver を利用する際には ipysankeywidget も必要になるため,別途インストールしてJupyterの拡張機能にてipysankeywidgetを有効化しておきます.
$ pip install ipysankeywidget
$ jupyter nbextension enable --py --sys-prefix ipysankeywidget
floWeaverの実装方法
さて,本題の floWeaver による可視化です.
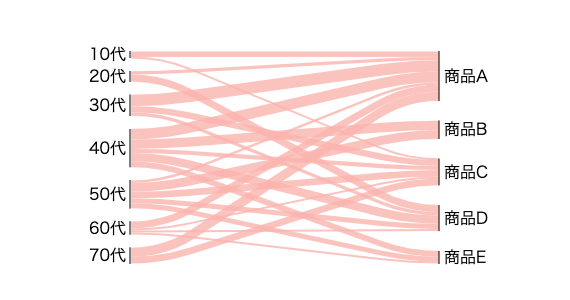
今回は公開されているデータセットではなく,自作した擬似データを用いてSankey Diagramを可視化していきます.ユーザの年代別に特定の商品がどれくらいの数量で購買されたのかを示すSankey Diagramを可視化していきます.
データ
まずは自作のデータを作成していきます.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib
from floweaver import *

np.random.seed(42)

size = 40
generations = np.array(["10代", "20代", "30代", "40代", "50代", "60代", "70代"])
channels = np.array(["メルマガ", "マスメディア", "Web広告", "SNS"])
products = np.array(["商品A", "商品B", "商品C", "商品D", "商品E"])

# 擬似データ作成
data = {
    "source": list(np.random.choice(generations, size=size)),
    "target": list(np.random.choice(products, size=size)),
    "channels": list(np.random.choice(channels, size=size)),
    "value": np.random.randint(0, 1000, size),
}

# データフレーム変換(重複除外)
df = pd.DataFrame(data).drop_duplicates(subset=['source', 'target', "channels"])

# typeカラムの追加
df['type'] = 'Not Recommendation'
df.loc[df.target.isin(['商品A', "商品B"]), "type"]  = "Recommendation"
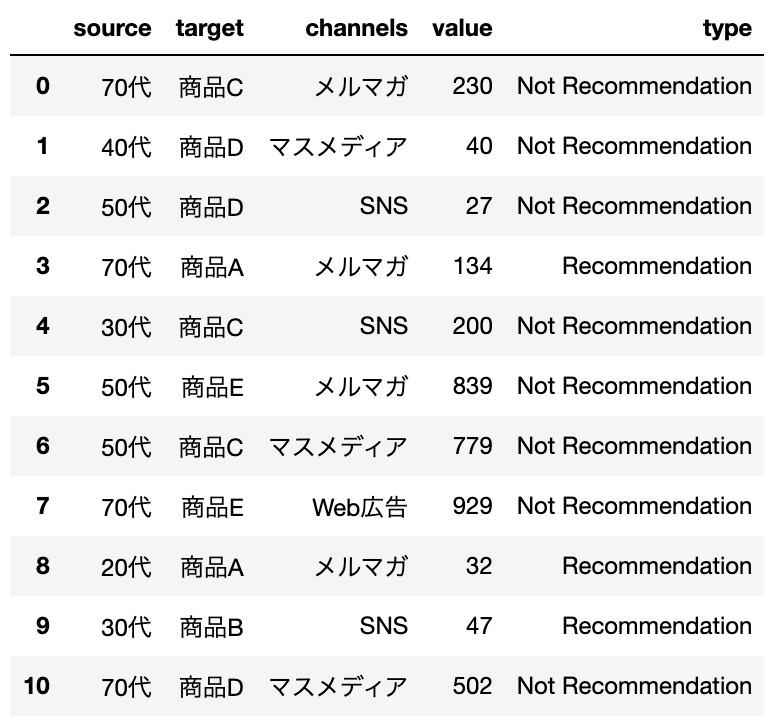
生成されたデータフレームについて少し解説すると,sourceカラムには年代,targetカラムは商品,channelsカラムは媒体・チャネル,valueカラムは購買数,typeカラムはお勧めフラグを示したデータとなっています. 実際に生成されたデータの一部は以下のようになりました.
可視化
続いて生成されたデータを用いて floWaeverによるSankey Diagramの可視化を実装していきましょう.
# サイズの指定
size = dict(width=570, height=300)

# 可視化時に表示するノードを定義
nodes = {
    "generations": ProcessGroup(["10代", "20代", "30代", "40代", "50代", "60代", "70代"]),
    "products": ProcessGroup(["商品A", "商品B", "商品C", "商品D", "商品E"]),
}

# 表示する順番の定義
ordering = [
    ["generations"],
    ["products"],
]

# コネクションの定義
bundles = [
    Bundle('generations', 'products'),
]

# ノードの中で項目を分けるためのパーティション定義
partition_generations = Partition.Simple(
    "process",
    ["10代", "20代", "30代", "40代", "50代", "60代", "70代"]
)
partition_products = Partition.Simple(
    "process",
    ["商品A", "商品B", "商品C", "商品D", "商品E"]
)

# 各ノードにパーティションを適応
nodes["generations"].partition = partition_generations
nodes["products"].partition = partition_products

# 可視化実行
sdd = SankeyDefinition(nodes, bundles, ordering)
weave(sdd, df).to_widget(**size)
上記のコードにより以下の図が作成されます.
各年代から各商品に対してどれくらいの購買があったのかを接続する線と線の太さで表現できていますね.ちなみに floWeaver ではカラムをキー名として流入元,流入先,線の太さを指定しており,デフォルトでは当該キー名が source ,target,valueとなっているため,今回もデフォルトの値を用いるように floWeaver に合わせてデータフレームを定義しています.
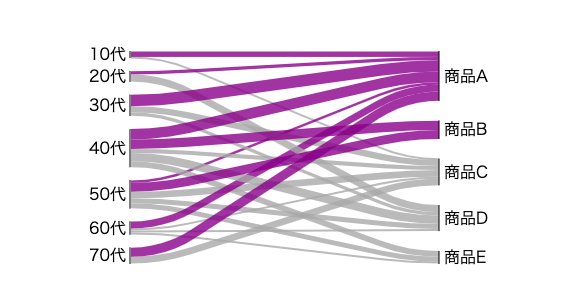
次に特定の商品の色を変更してハイライトしてみましょう.
今回はお勧めフラグが定義されている商品Aと商品Bについてハイライトしていきます.
size = dict(width=570, height=300)

# 可視化時に表示するノードを定義
nodes = {
    "generations": ProcessGroup(["10代", "20代", "30代", "40代", "50代", "60代", "70代"]),
    "products": ProcessGroup(["商品A", "商品B", "商品C", "商品D", "商品E"]),
}

# 表示する順番の定義
ordering = [
    ["generations"],
    ["products"],
]

# コネクションの定義
bundles = [
    Bundle('generations', 'products'),
]

# ノードの中で項目を分けるためのパーティション定義
partition_generations = Partition.Simple(
    "process",
    ["10代", "20代", "30代", "40代", "50代", "60代", "70代"]
)
partition_products = Partition.Simple(
    "process",
    ["商品A", "商品B", "商品C", "商品D", "商品E"]
)
partition_type = Partition.Simple(
    "type",
    ["Recommendation", "Not Recommendation"]
)

# 各ノードにパーティションを適応
nodes["generations"].partition = partition_generations
nodes["products"].partition = partition_products

# 可視化(paletteにて色の指定)
sdd = SankeyDefinition(nodes, bundles, ordering, flow_partition=partition_type)
weave( sdd, df, palette={"Recommendation": "darkmagenta", "Not Recommendation": "darkgray"}).to_widget(**size)
ハイライトする場合にはSankyeDifinitionクラスのインスタンスを生成する際のパラメータのflow_partitionにてPartitionクラスのインスタンスを指定し,その後のweave関数内のpaletteパラメータで色の指定を行います.
今回は商品Aと商品Bに該当するリンクがハイライトされており,特定の接続と流量の関係が把握しやすくなっていますね.
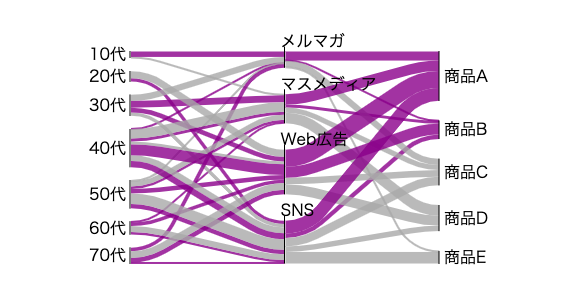
加えて,Sankey Diagramの接続点を増やしてみます.
生成したデータフレームにはchannelsカラムにて購買時にユーザ接点となったチャネルを定義しています.これを使って「ユーザ年代 - チャネル - 商品」の流入量を可視化してみましょう.
size = dict(width=570, height=300)

# 可視化時に表示するノードを定義
nodes = {
    "generations": ProcessGroup(["10代", "20代", "30代", "40代", "50代", "60代", "70代"]),
    "products": ProcessGroup(["商品A", "商品B", "商品C", "商品D", "商品E"]),
}

# ノードの中で項目を分けるためのパーティション定義
partition_generations = Partition.Simple(
    "process",
    ["10代", "20代", "30代", "40代", "50代", "60代", "70代"]
)
partition_products = Partition.Simple(
    "process",
    ["商品A", "商品B", "商品C", "商品D", "商品E"]
)
partition_type = Partition.Simple(
    "type",
    ["Recommendation", "Not Recommendation"]
)
partitiol_channels = Partition.Simple(
    "channels",
    ["メルマガ", "マスメディア", "Web広告", "SNS"]
)

# 各ノードにパーティションを適応
nodes["generations"].partition = partition_generations
nodes["products"].partition = partition_products
nodes['channels'] = Waypoint(partitiol_channels)

# 表示する順番の定義
ordering = [
    ['generations'],
    ['channels'],
    ['products'],
]

# コネクションの定義(waypointを指定)
bundles = [
    Bundle('generations', 'products', waypoints=['channels']),
]

# 可視化(paletteにて色の指定)
sdd = SankeyDefinition(nodes, bundles, ordering, flow_partition=partition_type)
weave( sdd, df, palette={"Recommendation": "darkmagenta", "Not Recommendation": "darkgray"}).to_widget(**size)
以下の図のように年代と商品の流入量の可視化の中にチャネルの中継点を加えて可視化できていることが見てとれます.このように中継点を加えていくことでより複雑な項目関係と流量を示すことができます.また,ハイライトも同時に適応可能なのでそれぞれのノード間の中で特異なデータの傾向を明らかにする際などに効果を発揮するかと思います.
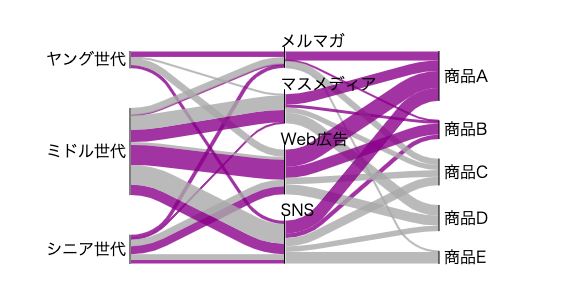
最後に,ノードの項目を集約する方法を記載していきます.
中継点を増やした先ほどのSankey Diagramでは接続する線が多くなって見辛くなってしまっています.ここでは,世代ノードの数をヤング世代(10代〜20代)とミドル世代(30代〜50代),シニア世代(60代〜70代)の3つに集約して図を見やすくしてみましょう.
size = dict(width=570, height=300)

# 可視化時に表示するノードを定義
nodes = {
    "generations": ProcessGroup(["10代", "20代", "30代", "40代", "50代", "60代", "70代"]),
    "products": ProcessGroup(["商品A", "商品B", "商品C", "商品D", "商品E"]),
}

# パーティション定義にてグルーピングを指定
partition_group_generations = Partition.Simple(
    "process",
    [ ("ヤング世代", ["10代", "20代"]), ("ミドル世代", ["30代", "40代", "50代"]), ("シニア世代", ["60代", "70代"])]
)
partition_generations = Partition.Simple(
    "process",
    ["10代", "20代", "30代", "40代", "50代", "60代", "70代"]
)
partition_products = Partition.Simple(
    "process",
    ["商品A", "商品B", "商品C", "商品D", "商品E"]
)
partition_type = Partition.Simple(
    "type",
    ["Recommendation", "Not Recommendation"]
)
partitiol_channels = Partition.Simple(
    "channels",
    ["メルマガ", "マスメディア", "Web広告", "SNS"]
)

# 各ノードにパーティションを適応
nodes['generations'].partition = partition_group_generations
nodes["products"].partition = partition_products
nodes['channels'] = Waypoint(partitiol_channels)

# 表示する順番の定義
ordering = [
    ['generations'],
    ['channels'],
    ['products'],
]

# コネクションの定義(waypointを指定)
bundles = [
    Bundle('generations', 'products', waypoints=['channels']),
]

# 可視化(paletteにて色の指定)
sdd = SankeyDefinition(nodes, bundles, ordering, flow_partition=partition_type)
weave( sdd, df, palette={"Recommendation": "darkmagenta", "Not Recommendation": "darkgray"}).to_widget(**size)
年代のノードの項目がヤング世代,ミドル世代,シニア世代の3つに集約されましたね.このようにノードの項目が多くなると非常に込み入った図になる場合もあるので,ノードの項目を集約してあげると可読性が向上するため,適切な状況に応じて活用すると良いです.
まとめ
今回はSankey Diagramの可視化を floWeaver というPythonライブラリを用いて行ってみました.こういったあまり利用頻度の高くない可視化パターンを適切な状況でレポーティングに活用できるようになると,周りからの見方も変わるかもしれないですね.これを機に頭の隅に新しい可視化パターンとしてストックしておいて,是非適切な場で活用してもらえると良いかと思います.
